Diaryzacja mówców — kto co powiedział w rozmowie z klientem
Diaryzacja mówców (ang. speaker diarization) to automatyczne dzielenie nagrania na fragmenty i przypisywanie ich do poszczególnych osób — odpowiada na pytanie „kto i kiedy mówił”.

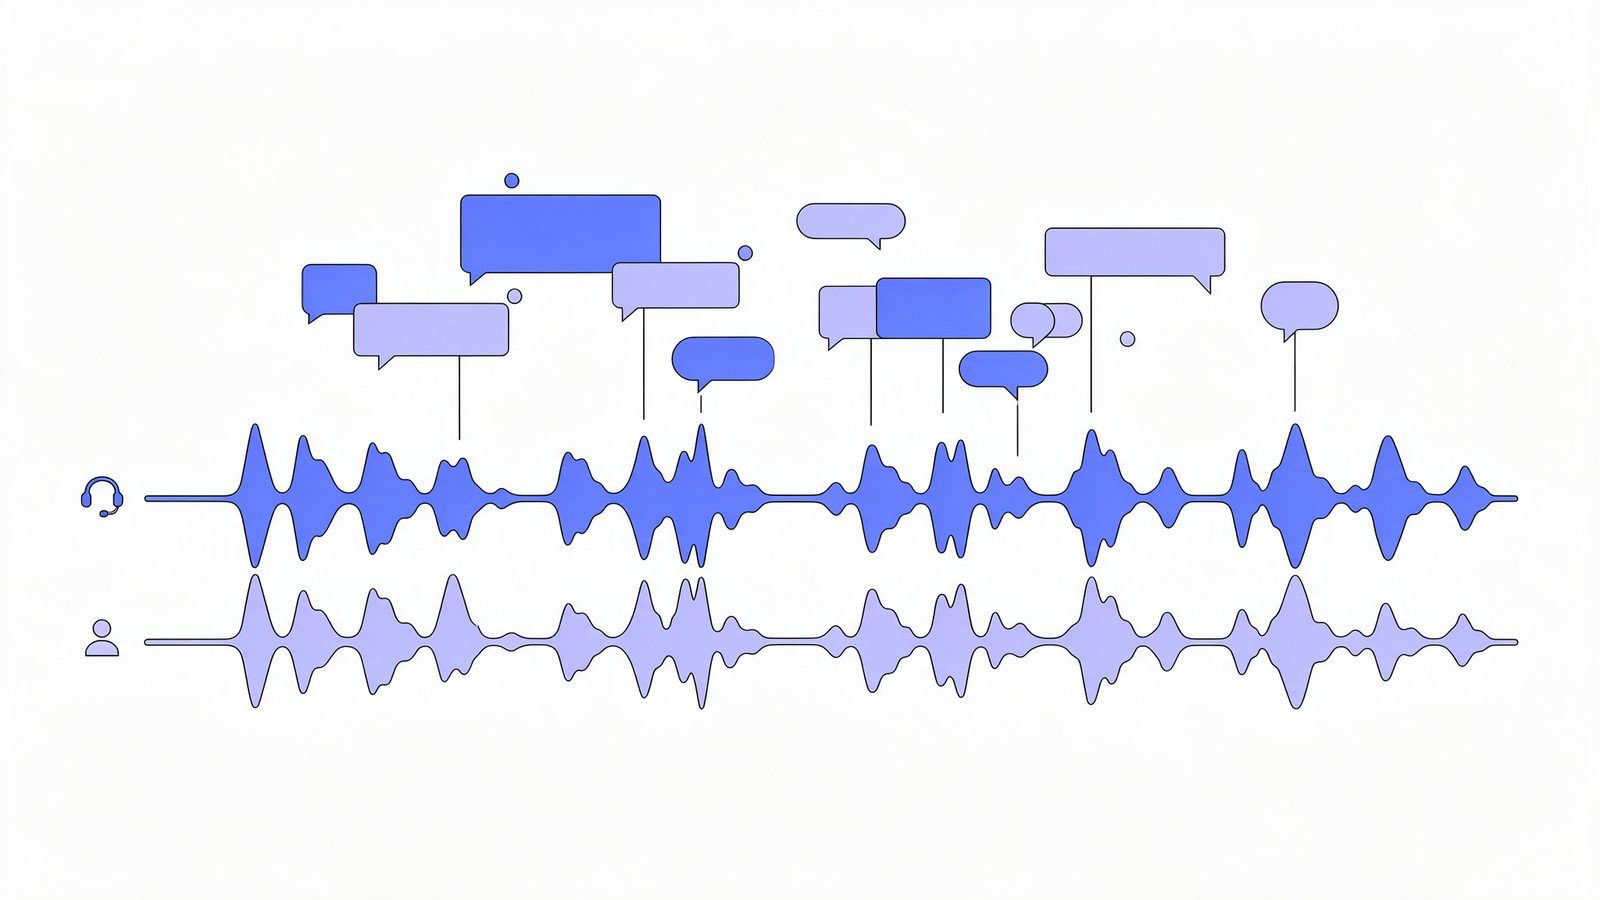
Diaryzacja mówców (ang. speaker diarization) to automatyczne dzielenie nagrania na fragmenty i przypisywanie ich do poszczególnych osób — odpowiada na pytanie „kto i kiedy mówił”. Transkrypcja mówi, co zostało powiedziane; diaryzacja dopisuje, kto to powiedział. Dopiero razem dają zapis, na podstawie którego można ocenić pracę konsultanta.
W rozmowach z klientami da się to osiągnąć na dwa sposoby. Jeśli centrala nagrywa agenta i klienta na osobnych kanałach, zadanie jest niemal banalne. Jeśli nagranie jest jednokanałowe (mono), system musi rozpoznać mówców po głosie — i tu zaczynają się błędy.
W skrócie:
- Diaryzacja = podział nagrania na fragmenty przypisane do mówców („kto i kiedy mówił”).
- Transkrypcja odpowiada na „co powiedziano”, diaryzacja na „kto to powiedział”.
- Diaryzacja jest anonimowa: rozróżnia Mówcę 1 i Mówcę 2, ale nie ustala, kim są. To odróżnia ją od identyfikacji i biometrii głosowej.
- Najprostsza i najpewniejsza metoda w call center to nagranie dwukanałowe — agent na jednym kanale, klient na drugim.
- Przy nagraniu mono wiele modeli zwraca etykiety mówców razem z transkrypcją, ale nie jest to niezawodne: mylą się przy podobnych głosach i gdy rozmówcy mówią jednocześnie.
- Bez diaryzacji nie da się sprawdzić, czy obowiązkową formułę wypowiedział agent, ani policzyć, kto ile mówił — czyli nie da się rzetelnie ocenić rozmowy.
Czym jest diaryzacja mówców
Diaryzacja mówców to proces, w którym system automatycznie dzieli nagranie na fragmenty i przypisuje każdy z nich do jednej z osób biorących udział w rozmowie. Nazwa pochodzi od angielskiego diary — dziennika, w którym zapisuje się, kto i kiedy zabrał głos.
Jak wygląda transkrypt po diaryzacji
Bez diaryzacji transkrypt to „ściana tekstu”:
Dzień dobry, nazywam się Anna, w czym mogę pomóc? Dzwonię w sprawie faktury za wrzesień,
kwota się nie zgadza. Rozumiem, czy może mi Pan podać numer klienta? Tak, to 48213.
Po diaryzacji każda wypowiedź ma etykietę mówcy i znacznik czasu:
[00:03–00:07] Mówca 1: Dzień dobry, nazywam się Anna, w czym mogę pomóc?
[00:07–00:12] Mówca 2: Dzwonię w sprawie faktury za wrzesień, kwota się nie zgadza.
[00:12–00:16] Mówca 1: Rozumiem, czy może mi Pan podać numer klienta?
[00:16–00:18] Mówca 2: Tak, to 48213.
W call center ostatni krok to zamiana „Mówca 1” i „Mówca 2” na „Agent” i „Klient”. To najprostsza część zadania: model językowy (LLM), który przeczyta całą rozmowę lub jej fragment, bez trudu rozpozna, kto się przedstawia nazwą firmy i prowadzi rozmowę, a kto dzwoni ze swoją sprawą.
Transkrypcja a diaryzacja — czym się różnią
Transkrypcja odpowiada „co”, diaryzacja „kto i kiedy”
Transkrypcja zamienia mowę na tekst — więcej o niej w tekście czym jest transkrypcja rozmów telefonicznych. Diaryzacja nie zmienia ani słowa w treści. Dopisuje do niej informację, kto mówi. Wiele współczesnych systemów robi obie rzeczy jednocześnie: zwraca tekst, znaczniki czasu (czasem z dokładnością do pojedynczego słowa, a nawet jego części) i etykietę mówcy przy każdej wypowiedzi.
Dlaczego liczy się podział na wypowiedzi, a nie same etykiety
Samo nazwanie ról jest łatwe — trudność leży wcześniej: w poprawnym podzieleniu nagrania na wypowiedzi. Weźmy fragment, w którym klient potwierdza zgodę krótkim „tak”, gdy agent jeszcze kończy zdanie. Jeśli diaryzacja dołączy to „tak” do wypowiedzi agenta, transkrypt wygląda tak:
Mówca 1: Czy wyraża Pan zgodę na nagrywanie rozmowy? Tak.
Mówca 2: Dobrze, to w czym mogę pomóc?
Agent „odpowiada sam sobie”, a w zapisie brakuje zgody klienta. Żaden model językowy tego nie naprawi, bo informacja o tym, kto naprawdę powiedział „tak”, zginęła na etapie diaryzacji. Dla kontroli jakości to różnica zasadnicza.
Diaryzacja, identyfikacja mówcy i weryfikacja głosowa — trzy różne rzeczy
Te pojęcia często się mieszają, a dotyczą różnych zadań:
| Diaryzacja | Identyfikacja mówcy | Weryfikacja głosowa (biometria) | |
|---|---|---|---|
| Pytanie | Kto i kiedy mówił? | Która to konkretnie osoba? | Czy to na pewno ta osoba? |
| Wynik | Mówca 1, Mówca 2 | „Jan Kowalski” | tak / nie |
| Czy ustala tożsamość | nie | tak | tak |
| Dane biometryczne | nie | zwykle tak | tak |
Diaryzacja: anonimowe rozdzielenie
Diaryzacja rozróżnia głosy wyłącznie w obrębie jednego nagrania. Nie porównuje ich z żadną bazą i nie wie, kim są rozmówcy.
Identyfikacja mówcy: przypisanie do konkretnej osoby
W call center tożsamość agenta zwykle znamy bez analizy głosu — wynika z danych centrali (kto był zalogowany na stanowisku). Diaryzacja wystarcza więc, by wiedzieć, które wypowiedzi należą do tego agenta.
Weryfikacja głosowa: potwierdzenie tożsamości
Weryfikacja głosowa porównuje głos z zapisanym wcześniej wzorcem, np. przy logowaniu do infolinii banku. To przetwarzanie danych biometrycznych, które podlega osobnym, surowszym zasadom — więcej w tekście o zasadach nagrywania rozmów z klientem. Diaryzacja anonimowa biometrią nie jest.
Jak rozdzielić agenta i klienta — dwie metody
Metoda 1: nagranie dwukanałowe — sprawa niemal banalna
Wiele central telefonicznych potrafi nagrywać rozmowę w dwóch kanałach (stereo): głos agenta na jednym, głos klienta na drugim. Wtedy diaryzacja sprowadza się do prostej reguły — wszystko, co jest na kanale agenta, powiedział agent. Nie trzeba analizować głosu ani zgadywać. Każdy kanał transkrybuje się osobno, a potem składa wypowiedzi w jedną oś czasu.
Dodatkowa korzyść: gdy rozmówcy mówią jednocześnie, ich słowa nie mieszają się, bo każde trafia na swój kanał.
Dwie rzeczy, na które trzeba uważać:
- Przesłuch — jeśli głos agenta „przecieka” na kanał klienta (np. przez echo), te same słowa pojawiają się na obu kanałach. Można go ograniczyć filtrami, które rozpoznają cichszy, opóźniony głos drugiej strony i wyciszają go przed transkrypcją. Takie rozwiązania rozwijamy także w InOro.
- Który kanał należy do agenta — zwykle to stałe ustawienie centrali, a nawet jeśli nie, model językowy rozpozna role z treści rozmowy.
Transkrypcja pojedynczego kanału ma też drobny koszt: model nie słyszy drugiej strony rozmowy, więc ma mniej kontekstu do rozpoznawania słów. Więcej o tym w tekście o jakości audio i dokładności transkrypcji.
Metoda 2: rozpoznawanie mówców po głosie w nagraniu mono
Jeśli centrala zapisuje rozmowę w jednym kanale, system musi sam ustalić, gdzie zmienia się mówca. Wykrywa fragmenty z mową, opisuje każdy z nich cechami głosu (barwa, wysokość) i grupuje podobne fragmenty w „mówców”.
Wiele modeli rozpoznawania mowy robi to od razu: oprócz tekstu i znaczników czasu zwraca etykietę mówcy przy każdej wypowiedzi. Są też osobne narzędzia wyspecjalizowane tylko w diaryzacji. Na końcu trzeba jeszcze ustalić, który mówca to agent — robi to model językowy na podstawie treści i to zadanie rzadko sprawia problem. Problemem są wcześniejsze błędy: wypowiedzi pocięte w złym miejscu albo przypisane nie temu mówcy.
To podejście działa, ale nie jest niezawodne. W naszych testach na polskich rozmowach telefonicznych wypowiedzi przypisane do złej osoby zdarzały się przy nagraniach mono w większości przypadków częściej niż przy podziale na kanały — u niektórych modeli nawet kilkukrotnie.
Porównanie metod
| Dwa kanały | Rozpoznawanie po głosie (mono) | |
|---|---|---|
| Pewność przypisania | bardzo wysoka — wynika z kanału | zależna od nagrania |
| Mówienie jednocześnie | nie przeszkadza | częste źródło błędów |
| Podobne głosy | nie przeszkadzają | częste źródło błędów |
| Wymagania | odpowiednia konfiguracja nagrywania w centrali | brak |
| Główne ryzyko | przesłuch między kanałami | pomylenie mówców |
Co zrobić, gdy centrala nagrywa w mono
Najpierw sprawdź, czy nagrywanie w dwóch kanałach da się po prostu włączyć — w wielu systemach to jedno ustawienie. Taka zmiana konfiguracji często daje więcej niż zmiana dostawcy AI. Jeśli nie da się tego zrobić, zostaje rozpoznawanie po głosie — wtedy warto regularnie sprawdzać próbkę rozmów, czy role są przypisane poprawnie.
Kiedy diaryzacja się myli — typowe błędy
Przy nagraniach mono najczęstsze problemy to:
Podobne głosy
Dwie osoby o zbliżonej barwie głosu — np. tej samej płci i w podobnym wieku — model potrafi uznać za jednego mówcę albo przypisywać ich wypowiedzi na zmianę.
Mówienie jednocześnie (crosstalk)
Gdy agent i klient mówią naraz, w nagraniu mono ich głosy nakładają się w jeden sygnał. Model przypisuje taki fragment jednej osobie albo ucina słowa drugiej.
Krótkie wtrącenia: „mhm”, „tak”, „rozumiem”
Krótkie potwierdzenia mają za mało dźwięku, by pewnie rozpoznać głos. Tymczasem „tak” klienta bywa kluczowe — np. jako zgoda na warunki umowy.
Więcej niż dwie osoby
Przełączenie do innego konsultanta, konsultacja z przełożonym, konferencja trójstronna czy członek rodziny przy telefonie klienta. Tu nawet nagranie dwukanałowe nie wystarcza, bo na jednym kanale mówią dwie osoby.
Słaba jakość audio
Szum i zakłócenia utrudniają nie tylko rozpoznanie słów, ale i głosu. Więcej w tekście o tym, co obniża dokładność transkrypcji.
Jakość diaryzacji mierzy się wskaźnikiem DER (Diarization Error Rate) — odsetkiem czasu nagrania przypisanego do złej osoby, pominiętego lub błędnie uznanego za mowę. W praktyce call center prostszy i bardziej użyteczny jest odsetek wypowiedzi przypisanych do właściwej roli: agent czy klient.
Dlaczego diaryzacja jest warunkiem rzetelnej automatycznej oceny rozmów
Karta oceny bez etykiet mówców nie działa
Automatyczna ocena rozmów (auto-QA) sprawdza, czy agent się przedstawił, czy zadał właściwe pytania, czy przekazał obowiązkowe informacje. Jeśli system nie wie, kto co powiedział, może zaliczyć agentowi coś, co powiedział klient — albo odwrotnie. InOro.ai ocenia 100% rozmów po ich zakończeniu na podstawie kart oceny dopasowanych do klienta — a każda z nich zakłada, że wiadomo, kto mówi.
Wskaźniki dostępne dopiero po diaryzacji
- Proporcja mówienia (talk ratio) — ile czasu mówi agent, a ile klient. W sprzedaży agent mówiący przez większość rozmowy to sygnał ostrzegawczy.
- Monolog agenta — najdłuższa wypowiedź bez udziału klienta.
- Przerywanie — jak często agent wchodzi klientowi w słowo.
- Cisza (dead air) — długie pauzy, np. gdy agent szuka informacji w systemie.
Compliance: kto wypowiedział formułę
W windykacji, sprzedaży czy ubezpieczeniach agent musi przekazać określone informacje. Formuła „rozmowa jest nagrywana” przeczytana przez klienta (np. gdy powtarza pytanie) nie spełnia obowiązku. Bez diaryzacji system tego nie odróżni.
Kto co obiecał
„Oddzwonię jutro do 12” powiedziane przez agenta to zobowiązanie firmy, które trzeba dotrzymać. „Wpłacę w piątek” powiedziane przez klienta w rozmowie windykacyjnej to deklaracja spłaty, którą warto odnotować. Te same słowa przypisane niewłaściwej osobie dają odwrotny wniosek — dlatego wyciąganie ustaleń z rozmowy ma sens dopiero wtedy, gdy wiadomo, kto je złożył.
Jak sprawdzić, czy Twoje nagrania nadają się do diaryzacji — checklista
Nie ma jednej konfiguracji, która pasuje do każdej centrali. Zanim wybierzesz rozwiązanie, warto odpowiedzieć na kilka pytań:
- Czy nagrania są dwukanałowe? To podstawowa informacja o każdym pliku audio — zwykle widać ją we właściwościach pliku.
- Czy jest przesłuch? Jeśli przy odsłuchu jednego kanału wyraźnie słychać drugą stronę rozmowy, trzeba to uwzględnić.
- Jak często zdarzają się przełączenia i konferencje? To przypadki, w których żadna metoda nie jest w pełni pewna.
- Jeśli nagrania są mono — czy da się włączyć nagrywanie stereo? Często wystarczy jedno pytanie do dostawcy centrali.
- Jak wypada próbka? Porównanie wyniku z odsłuchem kilkunastu rozmów mówi więcej niż jakakolwiek specyfikacja.
Nie musisz robić tego sam. W InOro.ai przechodzimy przez te pytania razem z Tobą na etapie wdrożenia i dopasowujemy rozwiązanie do Twoich nagrań — inaczej konfiguruje się system dla centrali nagrywającej czyste stereo, a inaczej dla nagrań mono z przełączeniami między konsultantami. Możemy dostosować m.in. sposób rozdzielania mówców, ograniczanie przesłuchu czy przypisywanie ról do specyfiki Twoich rozmów. InOro nie nagrywa rozmów — korzysta z nagrań, które już masz, jako nakładka na istniejący system.
A darmowe narzędzia z podziałem na mówców?
Dla pojedynczego nagrania — wywiadu, spotkania czy podcastu — darmowe i tanie transkryptory z podziałem na mówców zwykle wystarczą. Wynik da się przejrzeć i poprawić ręcznie.
W call center skala jest inna: tysiące rozmów miesięcznie, których nikt nie przejrzy ręcznie. Liczy się powtarzalność, automatyczne pobieranie nagrań z centrali, poprawne przypisanie agenta i klienta oraz kontrola nad tym, gdzie trafiają dane. Pytanie nie brzmi więc „czy da się podzielić rozmowę na mówców”, tylko „czy da się to robić niezawodnie dla każdej rozmowy”.
FAQ
Co to jest diaryzacja mówców?
Diaryzacja mówców (speaker diarization) to automatyczne dzielenie nagrania na fragmenty przypisane do poszczególnych osób. Odpowiada na pytanie „kto i kiedy mówił”. Rozróżnia rozmówców anonimowo — jako Mówcę 1 i Mówcę 2 — bez ustalania ich tożsamości.
Czym różni się diaryzacja od transkrypcji?
Transkrypcja zamienia mowę na tekst, czyli mówi, co zostało powiedziane. Diaryzacja dopisuje do tego tekstu, kto mówił i kiedy. Wiele systemów wykonuje obie operacje jednocześnie.
Czy diaryzacja rozpoznaje, kim jest mówca?
Nie. Diaryzacja tylko rozróżnia głosy w obrębie nagrania. Ustalenie tożsamości to identyfikacja mówcy, a potwierdzenie tożsamości głosem — weryfikacja biometryczna, która podlega osobnym przepisom.
Jak rozdzielić głos agenta i klienta w nagraniu?
Najprościej nagrywać rozmowę w dwóch kanałach — agent na jednym, klient na drugim. Wtedy przypisanie wynika wprost z kanału. Przy nagraniu jednokanałowym system rozpoznaje mówców po cechach głosu, co jest mniej pewne.
Kiedy diaryzacja się myli?
Najczęściej przy podobnych głosach, gdy rozmówcy mówią jednocześnie, przy krótkich wtrąceniach („mhm”, „tak”), przy udziale więcej niż dwóch osób i przy słabej jakości nagrania. Nagranie dwukanałowe eliminuje większość tych problemów.
Czy da się zrobić automatyczną ocenę rozmów bez diaryzacji?
Nie w sposób wiarygodny. Bez wiedzy, kto co powiedział, system może przypisać agentowi słowa klienta, nie policzy proporcji mówienia ani przerywania i nie sprawdzi, czy obowiązkową formułę wypowiedział agent.
Chcesz oceniać 100% rozmów bez ręcznego odsłuchu?
InOro.ai analizuje wszystkie rozmowy po ich zakończeniu, jako nakładka na Twoją obecną centralę (Genesys, Avaya, Cisco, API lub SFTP): automatyczna ocena według kart oceny, kontrola compliance i wyciąganie z rozmów powodów kontaktu oraz ustaleń. Dane przetwarzamy w UE, bez transferu poza EOG, a wdrożenie trwa typowo 1–2 tygodnie (przy dużych organizacjach dłużej).